- 面ごとの個別モデルから、全広告面を学ぶ単一の中央基盤モデルへ移行
- 新アーキテクチャKunlunで同一計算量の性能2倍、モデル複雑度2.5倍
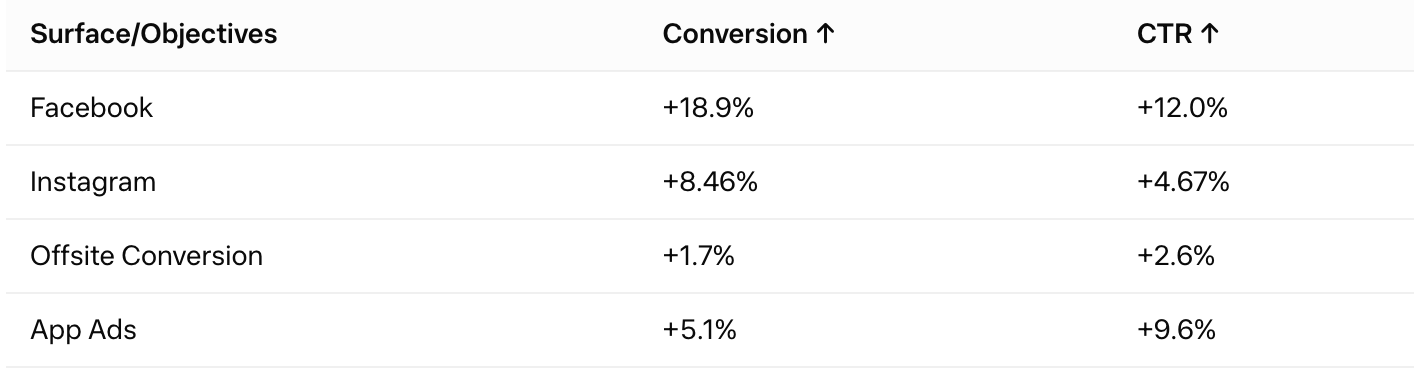
- 広告面と目的全体でコンバージョン18.9%、CTR12%の改善を報告
GEM刷新の全体像
Metaは2026年版のGEMを発表した。GEMは同社が「業界最大の推薦システム基盤モデル」と位置づけるもので、前年に導入された。2026年版では、FacebookやInstagram、Reelsといった面ごとの個別最適化から、Meta全体の広告プラットフォームのデータとシグナルを学ぶ単一の中央基盤モデルへと移行する。
効果として、Metaの広告面と目的全体でコンバージョンが18.9%、広告クリック率(CTR)が12%改善したと報告されている。加えて過去1年間で、対象ユーザーに対してFacebookで5.8%、Instagramで4.1%、オフサイトコンバージョンで1.6%のコンバージョン向上に寄与したという。
こうした改善はファネル上部の面から深いファネルの最適化目標まで及ぶとされる。認知、検討、コンバージョンまでを含む全体最適化を、複数の面にまたがって実現した点をMetaは強調している。
Kunlunとスケーリング則
推薦システムのモデルは、異種性の高い特徴量と分布の変化が大きいため、TransformerベースのLLMのようなスケーリング則がそのままは当てはまらないという課題があった。Metaは最新世代のGPUハードウェアと共同設計したLLM型アーキテクチャ「Kunlun」を構築し、より大きく深いモデルをコスト効率よく動かし、ユーザーの行動履歴に対する長文脈学習を可能にしたと説明する。
最大の事前学習スケールでは、旧版のInterformerと比べて同じ計算量で2倍の性能が得られ、GEMの以前のバージョンからモデル複雑度は2.5倍に増えたという。容量と文脈長を増やすほどランキング品質が創発的に向上し、それが事業成果に直結する点は最先端LLMのパターンと似ているとMetaは述べている。
設計面では、系列長に対する計算量を二乗から線形に下げるブロックアテンション、FFNをGDPA(Generalized Dot-Product Attention)として統合し最大2倍の順伝播高速化を狙う再定式化、専門家並列を用いたMoE型のクロスインタラクションが挙げられている。
知能転移と訓練効率
基盤モデルをそのままリアルタイムで配信するのはコストと遅延の面で現実的でない。そこでMetaは、知識蒸留に加えて構造表現「LoopFM」を導入し、中央モデルの内部表現と長期的な履歴記憶を下流モデルへ転移させる。計算を共有することで、追加の計算コストや遅延なしに知能転移の効果を2倍にしたという。上流モデルの利得を取り出すための弾力的な事前計算(Solaris)も導入された。
訓練基盤では、低精度のカスタムカーネルと新たな5次元並列戦略を、最新GPUおよびMetaの訓練クラスタと共同設計した。総訓練FLOPsを4倍にしつつ、数千GPU規模でエンドツーエンドの訓練効率を2倍にし、MFU(Model FLOPS Utilization)は20〜25%に達したと報告されている。
Metaは、データセンターGPUとそのソフトウェアスタックが主にLLM向けに最適化されている一方、推薦ワークロードはデータ特性が根本的に異なり、規模を広げながら高いGPU利用率を得るのが難しいと指摘している。
超長期系列と2つの法則
新しいアーキテクチャは超長期の系列を扱えるようにする。GEMは本番環境で長いエンゲージメント文脈長を2倍にし、さらに25倍まで拡張できる能力を備えたとしている。計算を省くCompSkipはFLOPSを43%削減しつつ品質劣化はごくわずかだとされ、異なるイベント特徴を持つ複数の系列を統合するOneSeqも導入された。
Metaは、予測品質が系列長に対してべき乗則に従い、その関係が系列長を通じて予測可能で一貫していると報告する。さらに大きなモデルほど長い系列から不釣り合いに大きな恩恵を受けるという。
これにより「計算を増やすとモデルが大きくなり、長い系列の価値が高まる。系列長を伸ばすと精度が上がり、より多くの計算が正当化される」という好循環が生まれるとMetaは説明する。単に計算量を足すのではなく、全体のスケーリング則の曲線を曲げる投資判断につながるという。
公表されていない点
今回のブログは技術的な仕組みの説明が中心で、訓練に使ったGPUの型番や台数、データ量、学習期間といった具体的な条件は示されていない。KunlunやLoopFMの詳細は別のコンパニオンブログに譲るとされており、本記事の末尾もLoopFMの構成要素の説明の途中で終わっている。
18.9%や12%といった改善率はMetaの広告面と目的全体を対象とした社内比較であり、測定条件や比較対象期間、統計的な検証方法は本記事では明らかにされていない。日本を含む他社・他地域のサービスに同じ枠組みを適用できるかについても言及はない。
そのため、個々の数値をそのまま他社環境の期待値として扱うことはできない点には注意が必要だ。
| 項目 | 旧GEM(Interformer) | 2026年版GEM(Kunlun) |
|---|---|---|
| アーキテクチャ | Interformer | Kunlun |
| 同一計算量での性能 | 基準 | 2倍 |
| モデル複雑度 | GEMの以前のバージョンが基準 | 2.5倍 |
| 知能転移の手法 | 知識蒸留 | 知識蒸留+構造表現LoopFM |
| 知能転移の効果 | 基準 | 蒸留比で2倍(追加計算コスト・遅延なし) |
Prediction quality follows a power law with sequence length. The relationship is predictable and consistent across sequence lengths.
予測品質は系列長に対してべき乗則に従う。この関係は系列長を通じて予測可能で一貫している。
今後の見通し
コンパニオンブログとして言及されている「Training GEM at LLM Scale」で訓練基盤の詳細が示されれば、5次元並列や低精度カーネルの実装を評価できる材料になるとみられる。Kunlunの設計詳細やLoopFMの残りの構成要素もそこで明らかになる可能性がある。25倍まで拡張できるとされる系列長が実際にどの面へいつ投入されるか、また18.9%や12%といった改善が今後の四半期でも持続するかが次の焦点となる。改善率の測定条件や比較期間が公開されれば、第三者が自社の推薦基盤と比較しやすくなる。
日本の開発者・IT企業にとっての意味
推薦モデルでもLLM的なスケーリング則が成立し、系列長とモデルサイズが互いを強化するという主張は、レコメンド基盤の設計方針に影響する。面ごとの個別モデルを並べる構成から、中央の基盤モデルと下流モデルへの知能転移という構成へ移行する判断材料になる。ただしLoopFMによる転移や5次元並列、CompSkipはMetaのクラスタとGPUの共同設計を前提としており、そのまま再現できるものではない。実務では、GPUコストと遅延の予算配分が論点になる。追加の計算コストや遅延なしに転移効果を2倍にしたという説明は、リアルタイム推論を軽くしつつ上流モデルを重くする設計の参考になる。MFU20〜25%という数値は、推薦ワークロード向けにカーネルと並列戦略を最適化した結果であり、LLM向けスタックを流用した場合との差を測る目安になる。
気になる点
- GEMの改善率は日本の広告配信でも同じように得られるのか
- 原文はMetaの広告面と目的全体における社内結果として18.9%などを示すのみで、地域別の内訳や日本での数値は公表されていない。対象ユーザー別の5.8%、4.1%、1.6%も同様に内訳が不明であり、他社環境で同じ効果が再現できるかは示されていない。
- 訓練にはどれくらいのGPU構成が必要なのか
- 原文は数千GPU規模で訓練したと述べているが、GPUの型番や台数、クラスタ構成、学習にかかった時間は示されていない。低精度カーネルと5次元並列戦略を最新GPUおよびMetaの訓練クラスタと共同設計したと説明されており、詳細は別のコンパニオンブログに譲るとされている。
- 自社の推薦基盤にKunlunの考え方を取り入れられるか
- ブロックアテンション、OneSeq、CompSkipといった要素の狙いは説明されているが、いずれも最新GPUとMetaの訓練クラスタとの共同設計が前提とされている。自社環境で同等の効果や効率が得られるかは、公開されている情報だけでは判断できない。
用語解説
- 推薦システム基盤モデル(RecSys foundation model)
- 複数の推薦タスクや面で共有して使う大規模モデル。個別タスク向けモデルの土台となり、知能転移の起点になる。
- MFU(Model FLOPS Utilization)
- 訓練中に理論上のピーク計算性能のうち、実際にモデル計算へ使われた割合。高いほど計算資源を無駄なく使えている。
- 知識蒸留
- 大きなモデルの出力や内部表現を小さなモデルに学ばせ、推論コストを下げる手法。転移できる情報量に制約がある。
- MoE(Mixture of Experts)
- 複数の専門サブネットワークのうち一部だけを入力ごとに使う構造。計算量を抑えながらモデル規模を拡大できる。
- ブロックアテンション
- 系列をブロック単位に区切って注意計算を行う方式。系列長に対する計算量を二乗から線形に近づける。
- スケーリング則
- モデル規模・データ量・計算量と性能の関係を表す経験則。推薦モデルでは当てはまりにくいとされてきた。
出典
Meta’s Generative Ads Model (GEM): Scaling the Central Model and Compute Engine for Frontier Ads AI
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する