- F3 Lightningは特徴量ごとの独立リリースで障害の影響を局所化
- 共有実行の効率維持に識別子・実行計画・共有バッファ・密インデックスを活用
- 比較可能な抽出特徴量の本番到達は約3.6倍高速、計算コスト増なし
発表内容
MetaのEngineeringブログは、F3 Lightningを紹介しました。F3は「Facebook Feature Framework」で、広告ランキングモデルを支える機械学習特徴量の記述、コンパイル、配信を行う枠組みです。1回のリクエストで20,000を超える特徴量が必要になる場合があるとされます。F3は2020年の「AI @ Scale」で初めて発表されました。
F3は全特徴量を単一のマージ済みグラフにコンパイルすることで、実行の計算コストを削減しました。しかしそのグラフ自体がリリース単位でもあったため、1つの障害や不正な定義がリリースパイプライン全体を止めます。F3 Lightningは、特徴量のリリースを共有実行から分離するインフラ層です。各特徴量を独立にコンパイル、検証、配備、ロールバックできるようにします。
F3の共有実行と課題
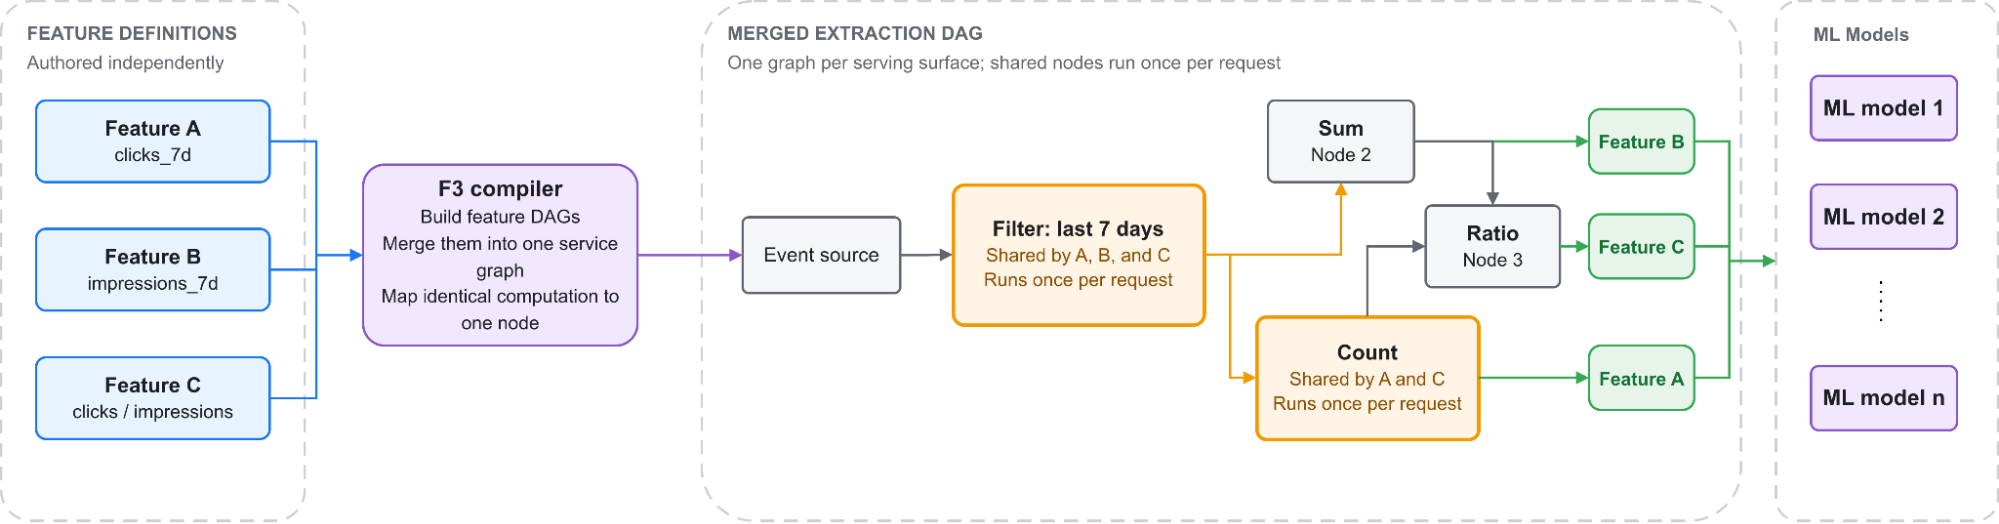
F3は特徴量抽出をDAGとして表現します。各ノードは入力読み取り、フィルタ、集計などの単位処理を行い、辺は処理同士の依存関係を表します。エンジニアは特徴量を個別の高水準言語で書き、コンパイラが各定義を小さなグラフに変換した後、サービスが使う全特徴量のグラフを1つにマージします。共有される処理は重複を畳み込まれ、リクエストごとに1回だけ実行されます。
このマージ済みグラフは計算効率に優れる一方、グラフ全体がリリース単位でもありました。原文では7つの特徴量A〜GのうちDとGに無関係な誤りがある例で、Dを直してもGで失敗し、両方を直すまで7つすべてが出荷できないと説明されています。F3が扱う特徴量は数百から20,000超に増え、特徴量の種類ごとに必要な検証も異なります。既存モデルが使う特徴量には高コストなモデル関連テストが必要で、それが後工程まで全体を待たせる要因になっていました。
独立リリースと効率維持
F3 Lightningの第一の変更は配備の粒度です。コンパイラは各特徴量を単独の設定としてコンパイルし、その特徴量に必要なノードを順序付きで含めます。ある特徴量に問題があっても、関係のない別の特徴量はリリースできます。リリース経路は一括配備ではなく順序付きキューになり、未使用の新特徴量は標準検証で早く出し、既存モデルが読む変更には追加テストを課す運用が可能になります。
ただし初期の試作では、独立配備にしたことで共有実行が失われ、CPU使用量が大きく増えました。そこでF3 Lightningは、計算の意味から識別子を導く仕組み、全特徴量をまたぎトポロジカルソートで依存順に並べた単一の実行計画、リクエストごとの共有メモリバッファ、識別子を連続した配列位置に変換する密インデックスを導入しました。これにより、同じ計算を1回だけ実行しつつ、実行時の参照を直接配列アクセスに近づけています。
成果と注意点
F3 Lightningでは、比較可能な抽出特徴量が従来のF3より約3.6倍速く本番に到達し、インフラの計算コストは増えないと報告されています。リリースサイクルが短くなれば、同じ期間により多くのモデル反復や再学習を行いやすくなります。これは特徴量の更新頻度がモデル改善の速度に影響する広告ランキングのような領域で意味を持つ数字です。
実行時には、ある計算が失敗したり入力が得られなかったりすると、その下流だけが「未準備」とされ、独立した別の枝は処理を続けます。つまり障害の影響は依存関係の範囲に限定されます。一方、原文では3.6倍の測定条件の詳細や、Metaのどのサービスにどの程度展開済みか、モデル品質への影響までは示されていません。効果の範囲を判断するには、今後の適用範囲や運用指標の公開を待つ必要があります。
| 項目 | F3 | F3 Lightning |
|---|---|---|
| リリース単位 | マージ済みグラフ全体 | 特徴量ごと |
| 共有計算 | マージ時に重複を統合 | 起動時に実行計画へ統合 |
| 障害時の扱い | 1つの定義不備で全体が停止 | 失敗した計算の下流のみスキップ |
| 本番到達速度 | 比較の基準 | 約3.6倍高速 |
| インフラ計算コスト | マージで削減 | 増加なし |
With F3 Lightning, comparable extraction features now reach production ~3.6x faster than on traditional F3, with no increase in infrastructure computational cost.
F3 Lightningでは、比較可能な抽出特徴量が従来のF3より約3.6倍速く本番に到達し、インフラの計算コストは増加していません。
今後の見通し
今後は、F3 LightningがMetaの広告ランキング基盤でどの程度広く適用されるかが焦点になります。約3.6倍という値は比較可能な抽出特徴量の本番到達に関するもので、モデル学習や評価を含む開発全体の短縮率ではない点に注意が必要です。適用範囲、測定条件、障害率、レイテンシへの影響が公表されれば、実運用での効果をより正確に判断できます。他のML特徴量基盤への応用や外部提供については原文で言及されておらず、現時点では不明です。
日本の開発者・IT企業にとっての意味
日本のIT企業にとって、F3 Lightningは特徴量のリリース単位をどう設計するかというML基盤の課題を示します。1リクエストで2万を超える特徴量を扱う場合、共有計算のためのマージは効率を上げる一方、1つの定義不備が全体の更新を止めるボトルネックになり得ます。F3 Lightningは、安定した計算識別子、起動時の実行計画、共有バッファ、密インデックスで独立リリースと共有実行を両立させました。自社の特徴量ストアを設計する際は、リリース単位、重複計算の排除、メモリ配置、ロールバック範囲を確認する価値があります。ただし、同様の仕組みにはコンパイラと実行基盤の設計変更が必要で、単純な設定変更では得られません。
気になる点
- F3 Lightningは日本企業も利用できますか
- 原文はMetaの広告ランキング向けF3上に構築した社内基盤として説明しており、外部向け提供やオープンソース化には触れていません。日本企業がそのまま導入できるかは現時点では公表されていません。設計思想は参考になりますが、利用可否は別途情報が必要です。
- 3.6倍高速化はどの工程の短縮ですか
- 対象は「comparable extraction features」と表現される比較可能な抽出特徴量の本番到達です。特徴量のコンパイルから配備までのリリース工程が短くなったことを指し、モデル学習や評価を含む開発全体が3.6倍になるという意味ではありません。測定条件の詳細は原文で限定されています。
- 計算コストを増やさずに独立リリースできるのはなぜですか
- 起動時に特徴量をまたぐ共有計算を識別して1つの実行計画にまとめ、共有メモリバッファと密インデックスで参照を効率化しているためです。これにより、実行時に同じ計算を繰り返さずに済むと説明されています。個別の数値や適用条件は原文で限定的です。
用語解説
- F3
- Metaの「Facebook Feature Framework」。広告ランキング向けML特徴量を記述・コンパイル・配信する枠組み。
- F3 Lightning
- F3上に構築されたインフラ層。特徴量ごとの独立リリースと共有実行の効率維持を狙う。
- DAG
- 有向非巡回グラフ。処理の依存関係を循環なしで表し、各ノードの計算を辺でつなぐ。
- 特徴量
- 機械学習モデルへの入力となる加工済みデータ。集計値やフィルタ結果などを指す。
- トポロジカルソート
- 依存関係に従い、前提処理の後に各処理を並べる順序付け手法。
- キャッシュミス
- CPUが必要なデータをキャッシュから読めず、低速なメモリ参照が発生する状態。
出典
F3 Lightning: How Meta Accelerates Ads ML Features to Production at Scale
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する